DeepSeek mHC多流残差坍塌失效了?
DeepSeek mHC多流残差坍塌失效了?对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
来自主题: AI技术研报
7949 点击 2026-09-28 16:22

 搜索
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
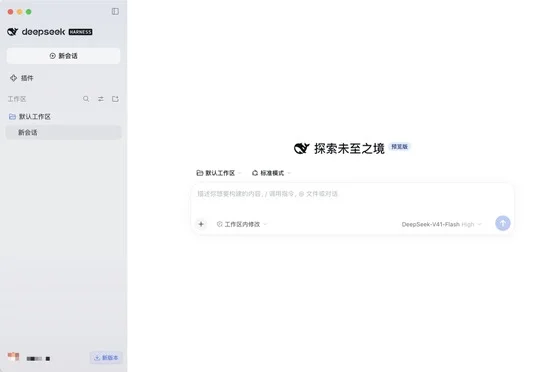
DeepSeek Harness推出桌面版,虽未经官方正式宣布但已通过苹果签名公证,内置智能体团队、语音输入等6个插件并提供标准、PTC、极简、创造四种工作模式,但目前仅支持macOS。
价格卷过DeepSeek Flash。
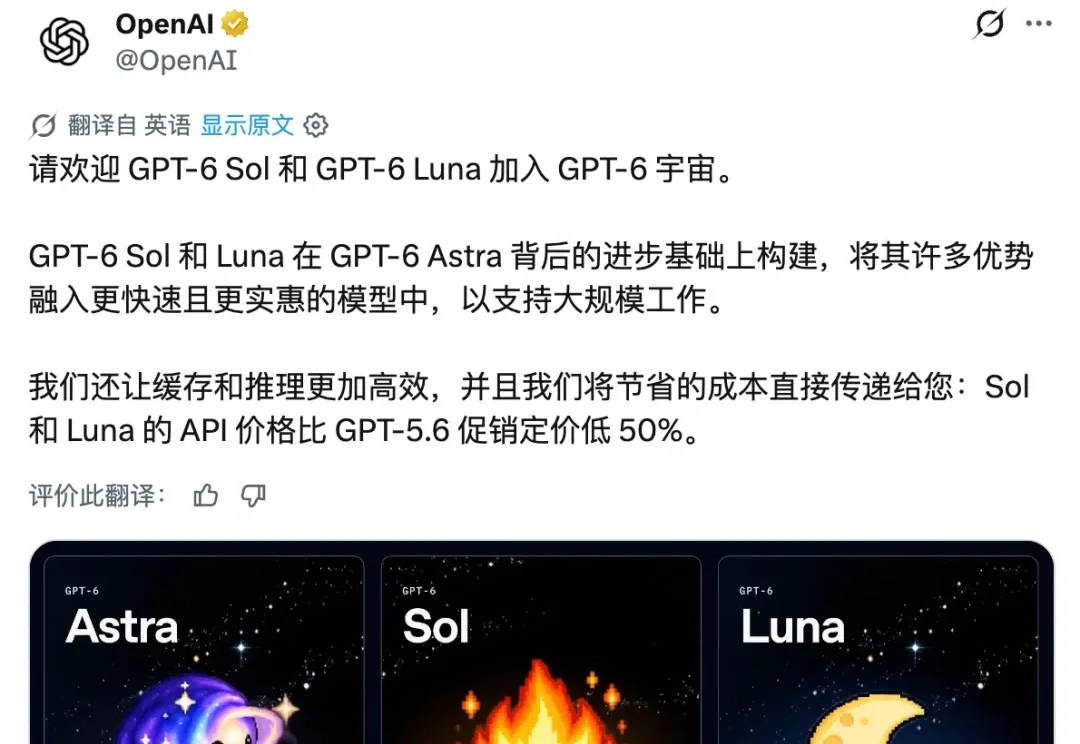
DeepSeek 快醒醒,ChatGPT 要打到家门口了。
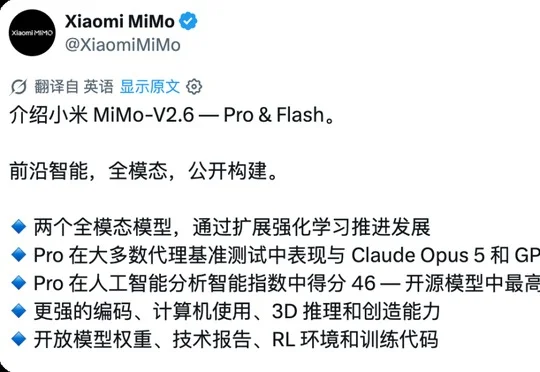
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
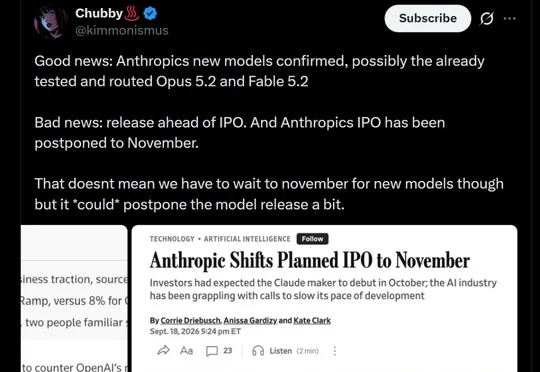
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
DeepSeek据悉将迎来高瓴创投90后合伙人严文韬出任CFO,同时已聘请中信证券筹备上海科创板IPO,并近期发布了DeepSeek V4.1 Flash模型,资本与产品双线加速推进。
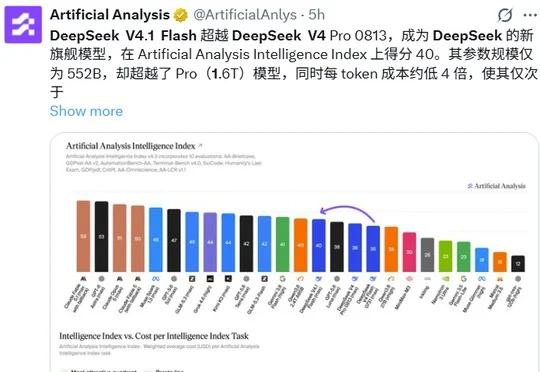
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。
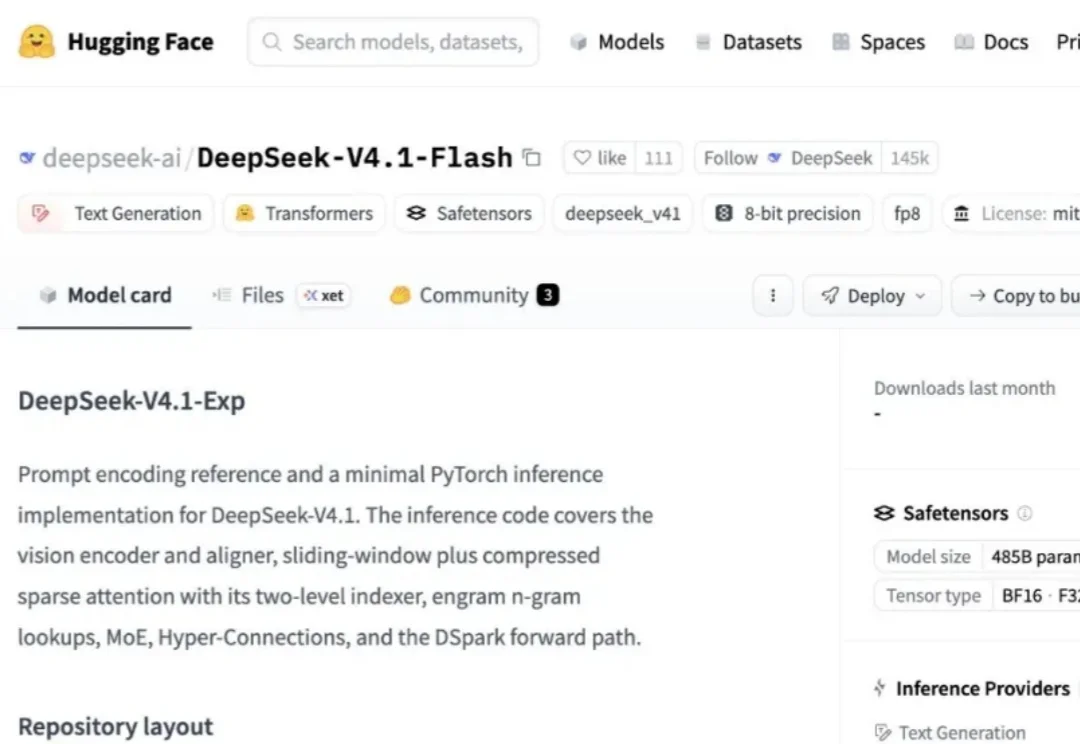
刚刚,DeepSeek 开源了 V4.1 Flash,原生支持视觉理解,也是全新架构系列中最小的一款模型,550B 总参数,输入时激活 8B,输出时激活 16B(你没看错,输入输出激活不同)
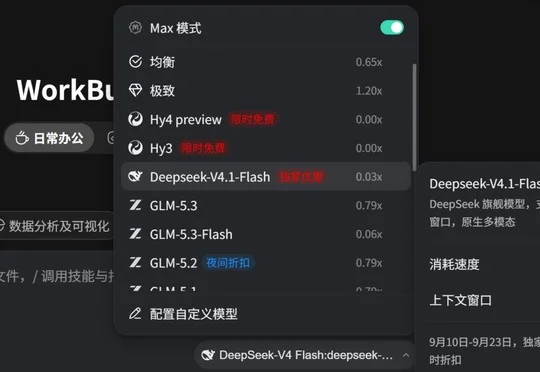
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。